先分清楚是谁在占带宽
带宽被占满时,第一反应常常是加带宽,但如果不弄清楚是谁在用,加了也只是给抓取的一方提供更多空间。先从访问日志里统计来源和请求量,看看排在前面的几十个来源各自贡献了多少流量、访问了哪些内容、有没有明显规律。多数情况下,少数几个来源会占去很大比例。
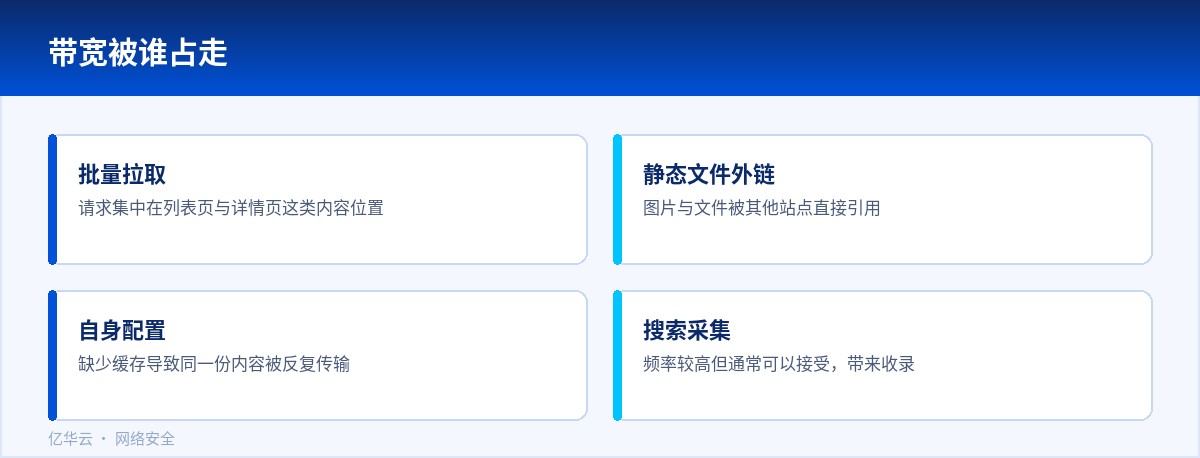
抓取的对象也值得看。如果集中在列表页和详情页这类内容量大的地方,多半是有人在批量拉取数据;如果集中在图片、视频这类静态文件,更像是被当成图床或者被页面外链占用。两种情况的处理方式完全不同。
还有一个容易被忽略的来源:自己的站点。缓存配置不当、页面里引用了过大的图片、静态资源没有压缩,这些都会让同一份内容被反复传输,看起来像是外部压力,实际是自己造成的。
判断是正常需求还是恶意抓取
搜索引擎的正规采集会带来收录和流量,代价是大方接受的。判断时可以看对方的标识、抓取的时间分布以及它是否遵守站点的抓取说明。正规来源通常有明显标识,节奏相对克制,也会遵循说明文件里的约定。
恶意的抓取则相反:标识随意伪造甚至为空,请求间隔均匀,长时间持续,而且专门挑内容量大、更新频繁的位置。有的还会刻意绕过限制,换地址、换标识,用一大批来源分散请求。
需要留意那些来自合作方或者用户的正常高频访问。比如内容聚合、比价、监控服务,它们的行为和爬虫很像,但是有业务意义的。处理之前先确认一下,避免把正常的合作打掉。
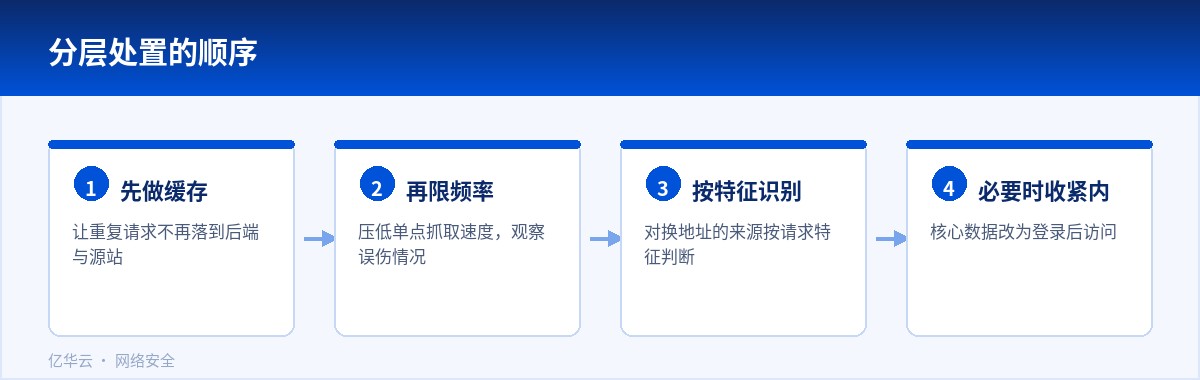
处置要分层做
最省成本的一层是缓存。静态资源加上合适的缓存策略,让重复请求不落到后端也不经过源站,能立刻减轻很大一部分压力。页面层面也可以对不常变化的内容做缓存,把后端处理的开销降下来。
第二层是限制。按来源或会话做频率限制,把单点的抓取速度压下来。对已经确认的恶意来源,可以加入拒绝名单;对反复更换地址的,按请求特征来识别比按地址有效。
第三层是内容保护。如果数据本身就是核心资产,可以要求登录后访问,或者对批量接口做更严格的校验。这一步会影响体验,适合放在前两层之后。
处置的顺序建议从宽到严,每一步都留出观察时间。一次把限制拉到最紧,误伤的往往是自己真正的用户。
处理完之后要回头看
带宽降下来之后,回头确认一下收录和访问是否受影响。抓取被限制得太狠,搜索引擎的更新频率会下降,这个代价有时比带宽更值得在意。
把这次的处理记录下来:对方是谁、用什么方式、最后怎么解决的。抓取这件事会反复出现,有了记录,下次能省掉很多重新判断的时间。
再把缓存和静态资源的配置当成常规工作。很多带宽问题不是被攻击造成的,而是配置长期没有优化,压力一大就暴露出来。站点规模在增长时,带宽的规划要跟着内容量走,而不是等到占满了再来补。
和合作方约定清楚
内容合作、数据对接这类正常的批量访问,最好的处理方式是提前约定:对方的标识是什么、每天大概多少请求、集中在什么时间、走哪个接口。有了约定,配置限制时就能给出对应的放行,而不是每次出问题再临时调整。
约定也要有例外通道。对方的业务量突然上升时,应该有个地方可以提出调整,而不是自己想办法绕过限制,或者干脆放弃合作。
把这些信息写成一份简短的说明放在团队里,值班的人遇到异常流量时能先对照一下,避免把合作方的正常调用当成攻击处理。
长期要看的几个指标
带宽的总体用量、静态资源的请求量、抓取来源的数量,这几个指标的变化最能反映实际情况。定期看一眼趋势,比等到占满了再查要从容得多。
指标放在同一个地方看,判断起来更快。分散在不同系统里,每次都要来回切换,时间久了就没人愿意看了。