日志里最先要看的是状态码分布
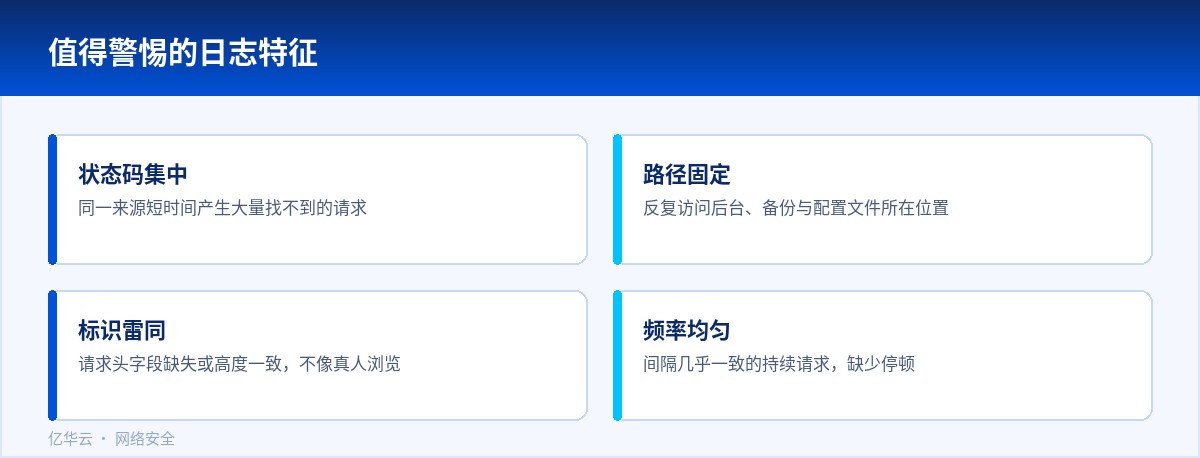
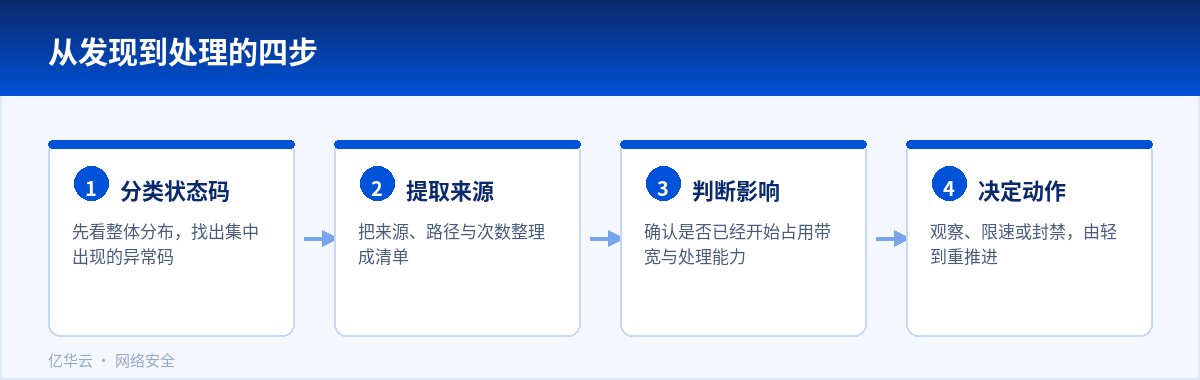
打开访问日志,第一眼很容易被大量的行数吓到,其实不必逐行去看。先按状态码分一下类:正常的页面请求大多集中在 200 和 304,找不到的页面是 404,被拒绝的是 403。如果某个来源在短时间内产生了大量 404,多半是在猜路径。
403 聚集在同一个来源上,通常说明对方在尝试访问那些不该公开的位置,比如备份文件、配置目录、管理入口。这类请求很少是误触,因为正常的访客不会主动去点这些地址。
也有相反的情况:某个来源的状态码非常整齐,全是 200,路径却固定在少数几个接口上,频率还很高。这种更像是在批量拉数据,而不是人在浏览。
路径和请求标识能看出工具
扫描器有自己习惯的路径。管理后台的常见地址、数据库管理工具的入口、版本控制留下的目录、编辑器生成的临时文件,这些都不在正常用户的浏览轨迹里。日志里出现它们,基本可以确定有自动化工具在跑。
请求头也有痕迹。正常的浏览器会带上一整套标识,一看就知道是什么系统、什么版本;工具往往只带一两个字段,或者干脆套用某个固定字符串。同一段来源的所有请求标识完全一样,同样值得注意。
需要提醒的是,这些特征都可以被伪造。把它们当作线索,用来判断要不要进一步观察,而不是当成结论。
频率和时间分布最能说明问题
人的访问是有停顿的。翻页、阅读、点击链接,中间总会有间隔。自动化的请求则常常均匀得反常:每秒几条,持续几分钟甚至几小时,间隔几乎一致。把同一来源的请求时间列出来,规律一眼就能看出来。
时间点也能提供线索。凌晨出现集中访问、节假日流量突然升高,如果业务本身没有对应的场景,就值得查一查。反过来,如果站点本来就有一个固定时间跑的采集任务,那种规律就不是问题,最好提前在记录里写清楚。
判断之前先了解自己站点正常的样子。没有基线,任何数字都看不出异常。
看到之后怎么处理
确认是扫描之后,动作可以分几档。只是低速探测的,记录下来观察即可,不必马上动手;速率明显偏高、已经开始占用资源的,先限制频率;持续高频且来源明确的,再考虑封禁。从轻到重,留出足够的观察时间。
处理的时候顺手把证据留下:来源、时间范围、命中的路径和次数。这些内容在设计规则时用得上,也能在事后解释为什么要做这个限制。
另外,别忽视那些请求很少、但每次都成功的来源。它们可能是有人在手动试探,也可能是一个忘了关掉的采集脚本,两种情况处理方式并不一样。
日志本身也要留够时间。只保留三天,等发现问题时现场早就被覆盖了,判断就只能靠猜。
把日志用起来的几个习惯
先确认日志里记了哪些字段。来源地址、时间、请求路径、状态码、请求头,这些是判断的基础,缺一项都会让分析变得吃力。
给日志留出足够空间并设置轮转,别让一个文件无限增长,也别让有用的旧文件被过早覆盖。
集中到一个地方看,比登录到每台机器上分别翻要快得多,站点有多台服务器时尤其明显。
常见的统计可以直接做起来:哪些来源请求最多、哪些路径被访问得最多、哪一类状态码在增长,每天看一眼趋势就够。
发现可疑来源之后,看它是不是只针对某一个站点。同一批人往往同时在扫多个目标,横向对比能确认这是一次普遍扫描还是专门针对你。
分析工具不必复杂,能按来源和时间筛选、能把结果导出,已经够用。
日志本身也是证据,留存的时间长一些,处理纠纷、排查事故时都用得上。
如果站点有多个域名指向同一套程序,日志里能看出哪些请求来自哪个域名,排查时很有帮助。
遇到无法解释的行,先用排除法确认它是不是自己的程序发出来的,比如是否来自搜索采集或监控。
把常用的筛选方式记下来,下次遇到类似情况可以直接套用,不必每次都重新摸索。
日志不是留着好看,而是要在需要的时候拿得出结论。





















