监控上的表现很像
两种情况在监控里的样子几乎一样:请求数上升,带宽变化不大,处理器占用和数据库连接数往上走,页面响应时间变长。所以第一反应容易搞错,把搜索的正常抓取当成攻击去封禁,结果收录掉了;或者把真正的攻击当成爬虫不予理会,等到服务不可用才反应过来。判断错了方向,后续所有动作都是白费力气。
差别在于目的和方式
正常爬虫的目的很单一,把页面内容取回去,所以它会完整读取响应,遵循站点声明的抓取约定,控制自己的请求节奏,并且在请求头里留下明确的身份标识。攻击不一样,它要的是让对方处理不过来,所以会挑最费资源的那几个接口,重复请求,参数略作变化让缓存失效,而且通常不关心响应内容,拿到结果或者超时就立刻发起下一次。
从哪几个维度区分
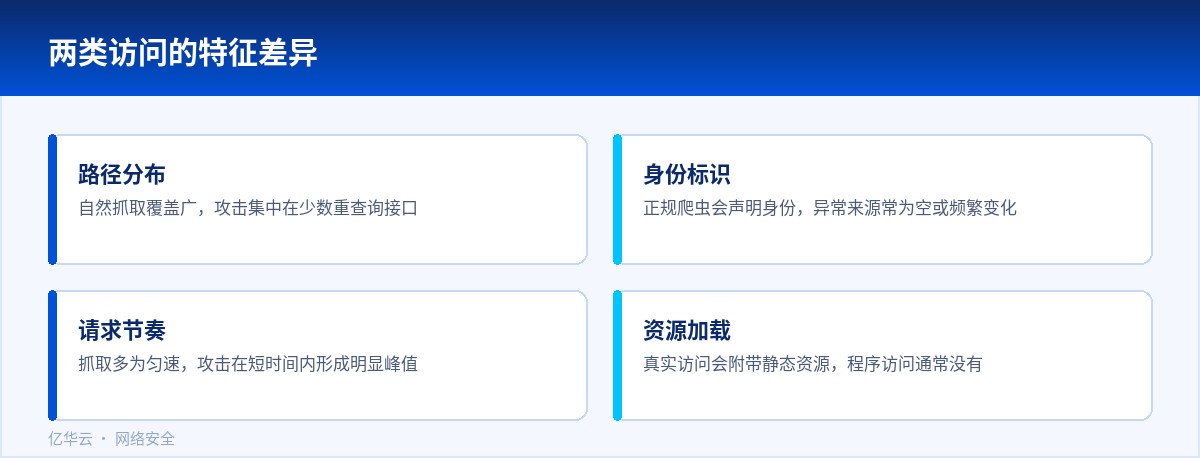
第一个维度是请求的分布。正常抓取会覆盖大部分页面,路径比较分散;攻击集中在少数几个接口上,重复率极高。第二个维度是会话特征,正规爬虫会带上自己的标识和来源信息,攻击方的标识往往空白或者频繁变化,而且不带任何静态资源请求。第三个维度是节奏,爬虫通常匀速,攻击则会在短时间内出现明显峰值。第四个维度是目标功能,抓列表页和详情页是正常的,盯着搜索、报表、验证码这类重查询接口反复打,就需要警惕。
误判的代价
把爬虫误判成攻击,最直接的后果是内容收录变慢,长期看影响流量;如果把搜索收录的地址整段封掉,恢复起来还要等重新抓取。反过来,把攻击当作爬虫放过,源站的资源会被持续消耗,数据库连接被占满之后,正常用户的请求也会一起失败。两种情况都要避免,所以判断规则不能只看请求数量这一个指标。
分开处置更稳妥
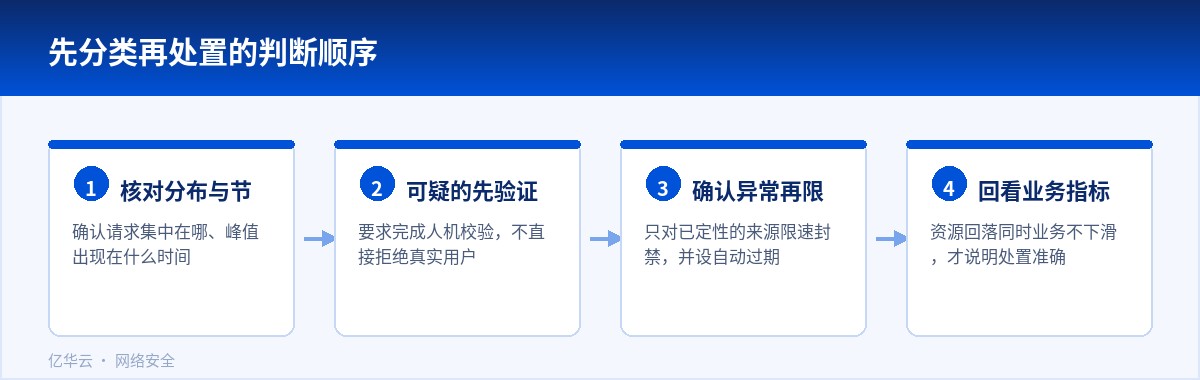
对确认是正规爬虫的,留出通道并按约定控制额度,让它拿到内容但不影响其他用户。对行为可疑但还没定性的,先要求完成一次人机校验,通过之后再放行,这样既不会直接拒绝真实用户,也能挡住大部分自动化请求。对已经确认在施压的来源,才做限速和封禁,并且设置自动过期。
整个过程里,业务指标要和资源指标一起看。资源用量回落但下单量、登录成功率也跟着掉,说明挡住的不只是攻击方;只有两者都正常,才能说明这次处置是准确的。判断完之后把结论和依据记下来,下次遇到同样的流量形态,就不需要再从零开始分析。
处理顺序比工具更重要
发现流量异常时,先别急着封 IP。第一步是确认影响范围:是所有用户都慢,还是只有某个页面、某个接口慢。如果只有一个接口被压住,问题多半出在那段业务逻辑本身,把访问频率降下来未必解决根本;整站都慢,才更像是流量层面的问题。
第二步是找特征。同一个地址、同一段地址、同一种标识串、同一个会话,都可能成为区分依据。观察几分钟就能看出重复的规律,比凭感觉设阈值可靠。第三步才是动手,而且要从宽到严:先限制频率,盯着有没有正常用户被误伤,再考虑更细的规则。
处理完记得回看日志,把当时设的参数和实际效果对一遍。流量的形态会变,上一次有效的设置,不一定一直有效。
被误伤的访问往往能提供有用信息。用户投诉某个页面打不开、某个接口时不时超时,回头对照规则和日志,常常能发现一条写得过宽的判断条件。把这类案例收集起来,比反复调整阈值更有方向。
另一种情况是规则本身没错,业务的行为却像攻击。定时任务集中在一个时刻跑、报表脚本并发很高,都会被当成异常。把这些已知的正常行为提前加进放行名单,能省掉很多解释工作。
流量不大的站点,先把日志和缓存做扎实,往往就能扛过大多数情况;规模上来之后,再考虑分流和更细的规则。工具跟着规模走,比一上来就堆配置容易维护。
改动之前先记下当时的状态,出事时才有回退的依据。





















