漏洞不是代码写错了那么简单
很多人对网站漏洞的印象停留在代码写错,其实相当一部分问题跟代码质量无关。同一个功能,在开发环境里跑得好好的,放到线上就出问题,因为线上的流量、数据量和访问来源都和测试时不一样。也有的是配置留下的:目录没有限制访问、错误信息把数据库结构吐给了浏览器、备份文件静静地躺在网站根目录里。还有一类来自第三方,用的框架版本太旧,组件本身带着已知问题,自己一行代码没错,照样被人利用。
所以看漏洞,更实用的角度不是问哪里写错了,而是问三件事:攻击者能从哪个入口把输入送进来,能借着什么身份做不该做的事,以及系统在异常输入下会暴露出什么。
漏洞一般出现在哪几个位置
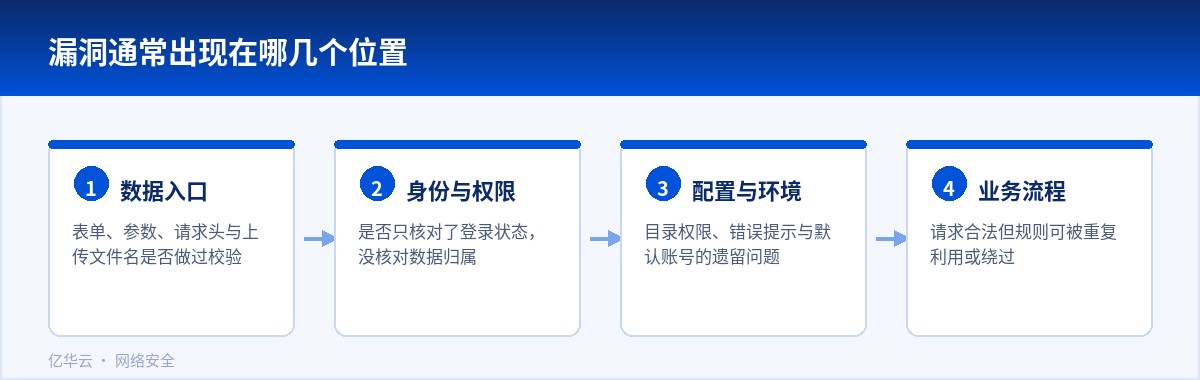
按位置分,最常见的有四类地方。第一处是数据进入系统的位置,表单、查询参数、请求头、上传的文件名,只要有一处没做校验,或者校验只在浏览器里做,就可能被绕过去。第二处是身份和权限判断,接口有没有核对当前用户能不能操作这条数据,很多时候只核对了有没有登录,却没核对是不是自己的数据。第三处是配置和运行环境,目录权限、中间件版本、错误提示的详细程度、默认账号,这些都算。第四处是业务流程,比如优惠券能不能重复领、订单金额能不能被改,请求本身完全合法,问题出在规则设计上。
几个典型类型和它们的表现
注入类问题的特征是输入被当成了指令执行。数据库查询里拼接了用户输入,就会变成 SQL 注入;命令拼接了文件名,就会变成命令执行。判断方法很朴素,看用户输入是否被直接拼进了会解释执行的地方。
脚本类问题发生在输出环节。用户提交的内容存进数据库时干干净净,等到页面渲染时才变成能执行的脚本,这类存储型的比反射型的更难发现,因为拦截的时机已经错过了入口。
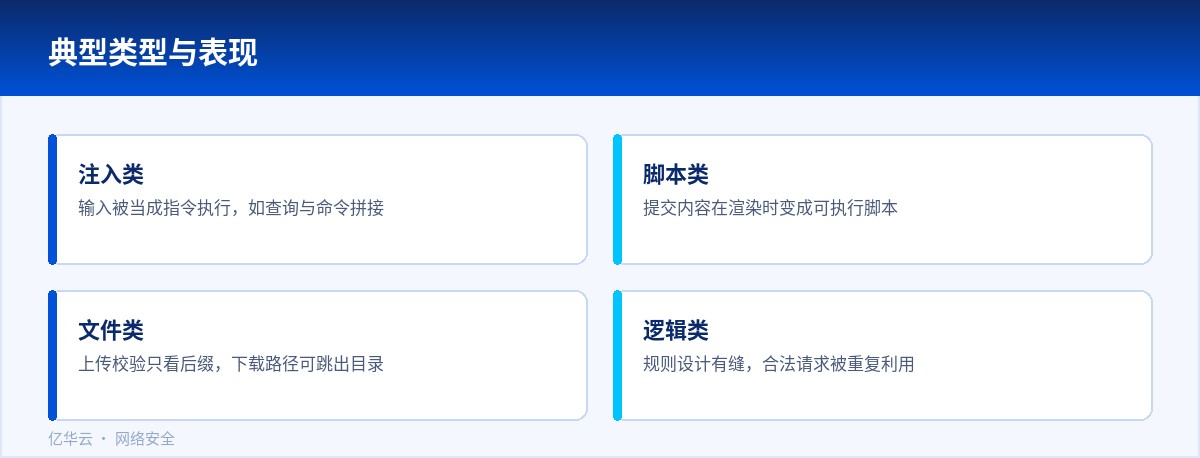
还有一类和文件相关:上传时只看后缀不看内容,下载接口的路径参数可以跳出限定目录,备份文件、日志文件被放在了能被公网访问的目录里。这些问题往往不需要高深技巧,扫一遍目录就能发现。
为什么同一个问题会反复出现
做过几次排查会有个感受:某类问题整改过,过一段时间换个模块又冒出来。原因通常不是没人管,而是修复只落在了当时那一处。参数化查询用在了一个接口上,新写的接口又回到了字符串拼接;上传限制加在了图片模块,附件模块还是老样子。要让一类问题真正消失,得把它变成默认做法,比如统一的数据访问层、统一的文件处理函数,让开发不需要每次都重新判断。
看到清单之后怎么用
拿到一份漏洞清单,先别急着按顺序全部处理。更有效的排序依据是三个问题的答案:这个位置现在能不能被公网访问,利用它需不需要先登录,一旦被利用会碰到哪些数据。三个答案都靠前的先改,靠后的可以排期。修完之后要能复测,否则报过的问题到底有没有真正解决,谁也说不清。那些改不动的老组件,至少要在入口处加一层针对性的拦截,把风险压到可接受的范围。
最后要接受一个现实:漏洞数量归零是不现实的。更实际的目标是让每个已知问题都有明确的处置状态,谁能碰、谁能改、什么时候能修完,都有人说得清楚。
清单之外的两件事
扫描报告动不动上百条,逐条处理既不现实也没必要。更省力的做法是先看入口:能从公网直接访问、又不需要登录的功能排在最前;需要特定身份、或者只在内部网络里能碰到的,可以往后放。同一份报告在不同业务上的分量差别很大,照搬别人的处理顺序意义有限。
另外,修复不是一次性的动作。改了什么、谁改的、什么时候改完,留一句简短记录。过几个月再有人问起同一个问题,翻记录比重新分析一遍快得多,接手的人也能少走一段弯路。





















