访问量涨了,不一定是好事
带宽突然跑满、数据库连接数飙高、监控告警连着响,第一反应往往是被攻击了。看日志才发现,是一个采集程序在按固定间隔遍历所有详情页,单个来源每分钟几百次请求。这类抓取不一定带恶意,但对配置不高的机器来说破坏力很直接:动态页面每请求一次就要查一次库,缓存被冲掉,正常用户打开变慢,极端情况下服务直接不可用。
识别爬虫和恶意访问,先要分清动机:有的是搜索收录,有的是竞品采集内容,有的是压测或者刷接口,还有的专门试探漏洞。处理方式差别很大,不能一刀切全封。
先把正常流量和异常流量分开
有几个维度比单看来源地址更靠谱。请求频率是基础指标,但要看时间窗口——同样是每分钟一百次,集中在前十秒和均匀分布,性质完全不同。访问路径的集中度也有信息量:正常用户会走首页、列表、详情这条路径,采集程序往往直接按编号递增遍历,中间不停留。再看请求头和会话特征,正规爬虫会声明身份并遵守抓取约定,伪装成浏览器却缺来源页、不加载静态资源的,就需要多留心。
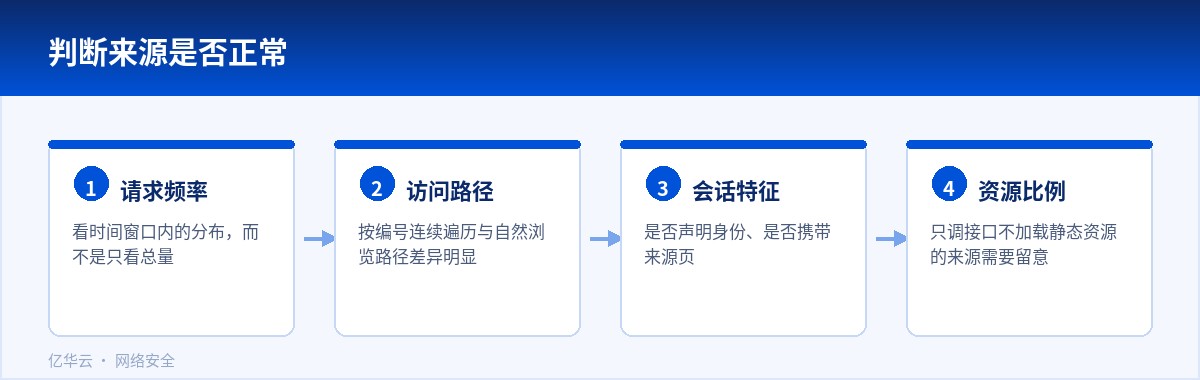
还要留意那些不请求任何图片和样式的来源。真实浏览器打开一个页面会附带十几个资源请求,纯接口调用不会。把静态资源的请求比例作为辅助指标,能筛掉不少伪装。
限速怎么配才有用
限速要在真正消耗资源的地方做,否则拦了请求也救不了后端。常见的配置位置有三处:边缘节点对单个来源做连接数和请求速率限制,适合挡大流量;webserver 层按路径或来源做额度控制,可以针对接口单独收紧;应用层对登录、下单、发帖这类接口做更细的频次限制,直接按账号或设备维度统计。
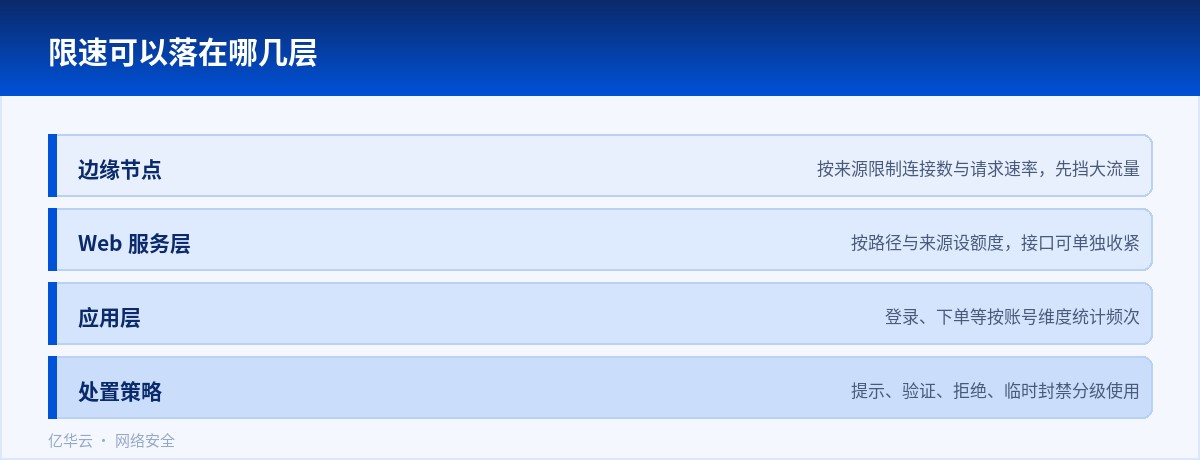
额度的取值要靠观察来定。可以先把阈值设在真实峰值的附近,跑一两周看正常用户的分布,再往上留出余量。对超过阈值的处理也分几档:返回等待提示、要求完成验证、直接拒绝、封禁一段时间。关键接口建议先拒绝再记录,别为了不影响少数用户把整体压垮。
限速之外,还可以从内容组织上降低被无序抓取的价值。把列表页做得更深、详情页之间的关联打散一些,按编号顺序遍历的成本就会上升;对同一来源的连续请求返回缓存内容,也能在不直接拒绝的前提下把源站压力降下来。这些做法替代不了限速,但能多一层缓冲。
站内搜索接口尤其要留意,它常被当成数据出口来用:构造一个能命中大量结果的关键词,然后翻页把内容全部取走。给这里的翻页深度加上限制,超出范围就不再返回结果,是很实用的一招。
名单本身也要定期清理。临时封禁设了过期时间还不够,静态写死的黑名单条目会随着时间越来越多,时间一长没人说得清哪条还有用。每季度拉一次清单,把已经失效的删掉,把仍然需要的换成按规则自动匹配,名单才能维持在一个可维护的规模。
还有一种情况是把来源封禁做在了错误的层级。在应用里判断再返回拒绝,请求其实已经进到了服务器,带宽和处理资源都已经消耗掉了;能挡在边缘或者防火墙层的,就不要留到应用里处理。
黑名单要用得克制
黑名单适合处理确定的问题来源,不适合当主力防御。按单个地址封禁的问题很明显:攻击者换个出口就绕过了,而共享出口下的正常用户会被误伤。比较稳妥的做法是按行为聚合——把同一时间段内表现一致的一组来源整体处理,同时设置自动过期时间,避免名单越积越长。
比封禁更长效的是给正规爬虫留出通道:在抓取约定里明确范围,为搜索收录单独配置更高的额度,把内容发布节奏和爬取节奏协调好。这样既保证收录,又不会把资源浪费在无序抓取上。限速上线后要持续看误伤情况,一旦发现正常用户被拦,先调额度而不是直接放行整段地址。





















