日志躺在那儿,出事才被翻出来
很多站点上线之后,访问日志就一天天写下去,直到某天页面被改、数据被删,运维才开始翻日志找线索。这时常见的情况是日志只保留了最近几天,或者按大小切分后被覆盖,出事的时间点刚好落在已经删掉的那一段里。还有一种是日志文件权限设成了所有人可读,同机上的其他用户都能打开,等于把访问来源、后台地址、接口参数全摊在那儿。也有站点把日志开得过大,每个请求连请求体和响应体都记一遍,磁盘一个月就写满,反倒把服务拖挂。
日志审计要解决的其实是三个问题:有没有留、留得够不够久、出了事能不能快速从里面捞出那几条可疑记录。这三件事在平时看不出差别,只有真出事时才分得出高下。
一次扫描在日志里是什么样
攻击者动手之前大多会先扫一遍。这段扫描在原始日志里其实很好认——同一个来源在一两分钟里请求了大量路径,中间夹着后台入口、数据库管理页、版本控制配置、环境变量文件和备份包这类从不属于正常业务的地址,状态码大多是 404,偶尔混一两个 200 就很值得追究。
除了路径特征,还有几个信号值得留意:请求里出现明显的注入关键字和编码痕迹;请求头里的浏览器标识是空值,或者一看就是脚本库的名字;同一时间点大量请求都带着同一个不常见的 Cookie;凌晨时段某个来源的访问量突然排到前面。把这些信号做成统计,比一行行翻日志高效得多。
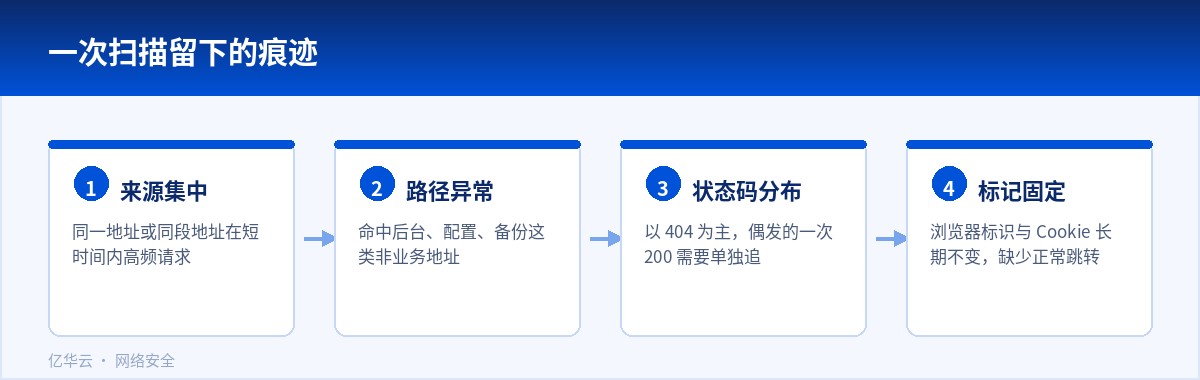
单看一条 404 说明不了什么,搜索引擎爬虫、失效外链、用户输错地址都会产生。有意义的是组合:短时间内高频 404,加上敏感路径,再加上固定的脚本标识,同时满足这几条的基本可以判定为扫描。
该收哪些日志,放到哪里
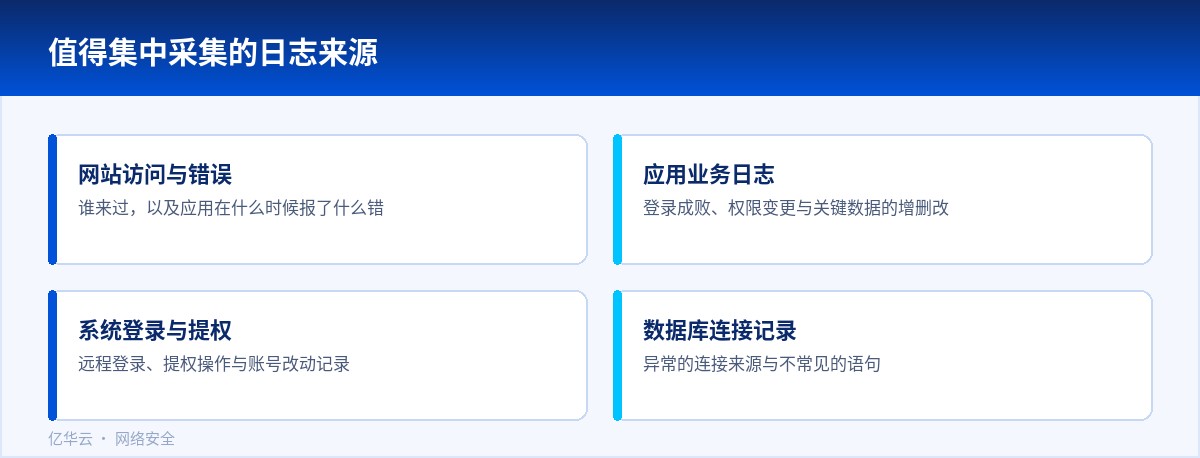
网站侧至少要有 webserver 的访问日志和错误日志,前者看谁来过,后者看应用报了什么错——很多探测会触发可预期的异常,错误日志里往往先露出马脚。应用层要记录登录成功与失败、权限变更、关键数据的新增修改删除。系统侧关注登录、提权操作、新建用户和计划任务变更。数据库的慢查询与连接来源也别丢。
落到哪里很关键。一个实用的做法是把日志集中送到与业务机分开的地方,用采集组件推到独立的存储或日志服务里。这么做有两个好处:攻击者拿到主机权限也改不掉已经送出去的记录;查询和统计不必占用业务机的资源。日志本身要限制读取权限,传输过程加密。保留时长按合规要求来,一般不少于半年,涉及资金或个人信息的业务还要更长。
让告警替你盯着
日志量大的时候靠人看是不现实的,得把关键模式变成告警规则。比较有用的几条:单个来源在五分钟内触发敏感路径超过若干次;同一账号连续登录失败达到阈值;非工作时间出现后台登录成功;某个来源的请求量在十分钟内翻了好几倍;错误日志里同一类异常短时间内集中爆发。
阈值要通过观察真实流量慢慢调。一开始设得太严,运维会被误报淹掉,最后干脆把告警关掉,那等于没配。落地时给每类告警标注紧急程度,把真正需要立刻处理的单独推送,其余的并入日报,每天固定时间过一遍。
还有一点容易被忽略:告警配好了,但没人知道收到之后第一步该做什么。把每类告警对应的动作写下来,比如敏感路径高频命中就先看来源是否集中,登录失败激增就先确认有没有账号已经被猜中,值班的人照着做就行,不必临场判断。这样一来,响应速度取决于流程,而不是某个人当时的状态。
发现异常之后
确认是攻击之后,先做两件事:隔离和留证。把日志、进程、网络连接状态、临时文件都保存下来,再考虑封禁来源、下线被上传的文件、重置可能泄露的账号口令。顺序反了会毁掉证据,也说不清到底有没有数据被拿走。
事情过去之后,回到日志里找根因:入口是从哪个接口进来的,为什么能通过,同类问题在别处有没有。审计的价值不在于事后抓住了谁,而在于把这次暴露出的薄弱点补上,让下一次同样的扫描进来之后什么都拿不到。时间久了回头看,日志里那些被忽略的小异常,往往就是最早的一次预警。





















